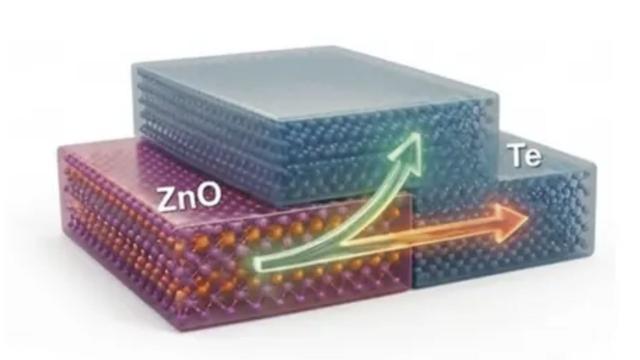
图释:ZnO–Te异质结器件的结构以及双NDT、D-NDT特性,在单一器件内产生双电流峰。POSTECH
SCIENCE RAZOR
你手机芯片指甲盖大小,里头塞了上百亿个晶体管。它们只会干一件事:开,关,开,关。七十多年没变过。
最近,韩国浦项科技大学(POSTECH)团队把这个沉闷规则捅了个窟窿。他们搞出一种新晶体管,一个能顶好几个。结果很直接:电路所需元件数量暴减75%,数据处理速度翻了4倍。
一个开关,五种状态
传统晶体管只认0和1。你看的短视频、科学家头疼的蛋白质折叠计算,本质全是无穷无尽的0和1排列。
要处理更多信息,过去只有堆晶体管这条路。你的CPU从几千个堆到几百亿个。物理学家早就警告,原子尺度就是死胡同。
POSTECH团队换了活法。他们没在“把开关做小”上卷,弄出了基于硅的“多值逻辑”晶体管。这器件能稳在五个不同电流状态,不再是只喊“是/否”的简单开关。
同一个晶体管,以前最多存1个比特,现在能存3个比特甚至更多。原来要好几个晶体管组团干的逻辑活,它自己就搞定。电路从臃肿军团秒变特种兵。
论文数据摆在那:速度快4倍,元件砍掉四分之三。不是修修补补,是直接改规则。
怎么做到的?
关键在于精准拿捏“阈值电压”。
传统场效应晶体管像一道门:电压够,门开,电流通,算“1”;电压不够,门关,算“0”。只一道门槛。
POSTECH的器件好比多道门槛的旋转门。他们在单个晶体管里集成了两个串联存储节点和控制栅极,靠精准调控电子隧穿和捕获,让器件稳稳停在好几个电流档位,每档都清晰,不乱跳。
这样一来,一个器件就能执行“与或非”这类组合逻辑运算,原本需要多个晶体管级联。电路复杂度从根上被简化。
为啥非跟几纳米过不去?
把晶体管做到3纳米、2纳米不香吗?快做不动了。
逼近1纳米,量子隧穿让电子到处乱窜,开关根本守不住0和1。
更要命的是功耗。数据中心和AI大模型吃电如喝水。你和ChatGPT聊一次天,背后几万张显卡在疯狂“0-1-0-1”。如果不能在单位功耗下塞进更多算力,AI革命的下一幕不是被算力卡住,而是被电费单直接拍沉。
韩国团队这个技术,是让晶体管“肚子更有货”。既然横向做密快到头了,那就让每个器件多干活。一个顶四个,等效算力密度和能效可能翻几倍。
关键差距:它不飘
这项研究最值得高看的一点:不悬浮。
首先,它用硅。碳纳米管、石墨烯等替代方案大多死在实验室,因为跟现有硅基产业链不合。POSTECH的器件用了标准CMOS兼容的浮栅结构,意味着不必推倒重来,存在嵌入现有产线的想象空间。
其次,工作电压低。低电压、低功耗,直击手机待机到数据中心散热的共同痛点。
当然,从实验室单个器件到装进你手机的量产芯片,中间还有制造均匀性、缺陷率、封装测试、EDA工具这些硬骨头。但至少,它在正确的赛道上。
谁在盯着?
能让计算效率跳变的技术,大国都紧盯着。
美国路子不同。麻省理工、斯坦福、英特尔、IBM等押注存内计算和模拟计算,想打破计算与存储单元的墙,在存储器里直接算,绕开“冯·诺依曼瓶颈”。
韩国是正面强攻晶体管逻辑能力不足。路数不同,目标一样:在物理极限下继续榨算力。
中国这边,这个细分领域的公开可比成果不多,没法排位。但方向值得琢磨。尤其先进制程受限的当下,如果不能在小尺度上狂奔,那就在“把现有晶体管用得更聪明”上下注。靠架构和逻辑创新补制程差距,是一条很务实的突围路。
最后追问什么?
这项研究和全球一堆类似尝试,最终都指向一个问题:
智能的物理极限在哪?
整个数字文明建在“0”和“1”这个极简单的物理抽象上。它模仿不了人脑那种低功耗、模糊、高度并行的处理。一个神经元连上千个其他神经元,它的状态绝不是简单“放不放电”。
POSTECH的五态晶体管,是在二进制铜墙铁壁上凿开的一个小孔。让我们瞥见一种可能:未来的芯片,未必需要几百亿个只会“是/否”的简陋开关。也许一个不那么“纯粹”但更复杂的计算基元,才是通往高效智能的钥匙。
第一台计算机ENIAC用了18000个真空管,重30吨,算力不如你手腕上的电子表。如果这项技术未来十年走出实验室进产线,我们手里设备的内部逻辑,将发生集成电路诞生以来最深刻的一次蜕变。
— 感谢阅读 · 欢迎点赞关注 · 科学剃刀 —
创通网提示:文章来自网络,不代表本站观点。